O ‘doom loop’ da IA: documentos revelam riscos para publishers
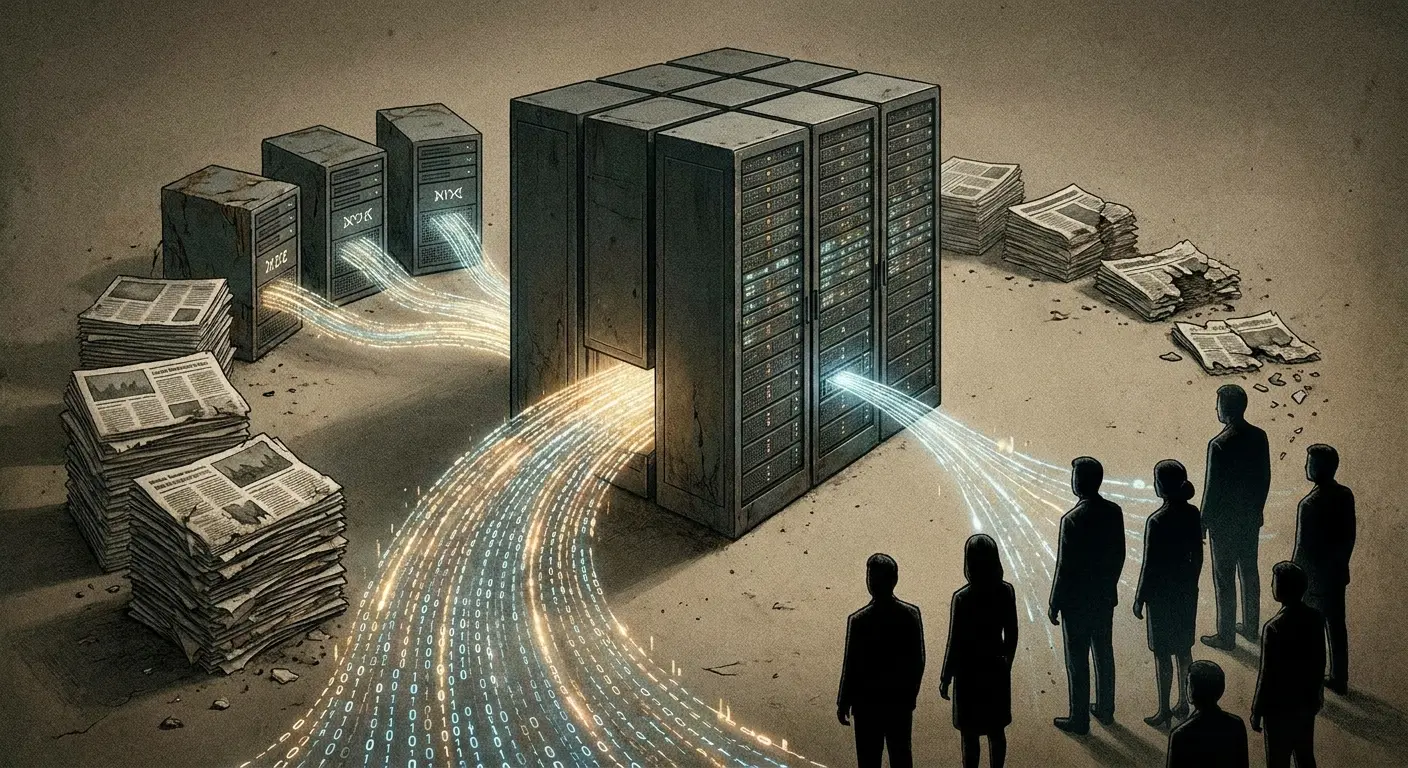
Representação artística do fluxo de informações e processamento de dados digitais.
A disputa judicial sobre direitos autorais envolvendo grandes modelos de linguagem ganhou novos contornos econômicos. Novos registros revelam como executivos debateram o doom loop da IA e o impacto direto dos buscadores generativos sobre os produtores de conteúdo jornalístico.
O que os novos documentos revelaram
Trechos não censurados do processo movido pelo The New York Times contra OpenAI e Microsoft vieram a público em setembro de 2026. Segundo reportagem da TechCrunch, os autos trazem comunicações internas e depoimentos de executivos de tecnologia.
As peças detalham como sistemas generativos utilizam acervos de notícias em larga escala. Além disso, os registros expõem dados concretos sobre a redução no tráfego enviado aos veículos de imprensa.
Por que a palavra “roubo” exige contexto
Em um dos trechos citados na petição dos autores, o pesquisador Brent Hecht teria classificado a raspagem indiscriminada de dados com termos severos. No entanto, é fundamental manter a precisão jurídica.
A expressão consta na petição inicial redigida pelos advogados do jornal. A TechCrunch ressalta que muitos documentos probatórios subjacentes continuam sob segredo de justiça. Portanto, a frase reflete um debate corporativo interno citado pela acusação, e não uma confissão judicial de infração de direitos autorais pelas empresas rés.
O “doom loop” previsto dentro da Microsoft
Documentos corporativos de 2024 citados no processo descrevem o conceito de “doom loop” da IA. O memorando aponta um dilema estrutural nos mecanismos de resposta.
Quando motores de resposta entregam a informação pronta, o usuário não visita o site de origem. Consequentemente, o veículo jornalístico perde receita publicitária e assinaturas. Sem recursos, a produção de reportagens originais diminui, esgotando o material fresco necessário para alimentar os próprios sistemas de inteligência artificial.
E essa situação fica bem clara com o aumento das buscas sem cliques no Google.
Quando uma resposta de IA substitui o clique
Os dados apresentados pelos autores indicam que as respostas sintetizadas reduzem drasticamente o engajamento direto. Registros internos anexados à ação mostram uma queda de até 93% na taxa de cliques (CTR) para páginas do NYT no assistente Copilot em comparação com a busca tradicional do Bing.
Portanto, a experiência sem clique deixa de ser uma hipótese teórica e já se consolida como uma transformação econômica mensurável no consumo digital.
Paywalls, datasets e copyright
O processo judicial aponta o uso de conjuntos de dados contendo dezenas de milhares de textos protegidos. Em depoimento citado nos autos, o CEO da Microsoft, Satya Nadella, declarou que o uso de conteúdo protegido por paywall deveria envolver licenciamento prévio para ancoragem (grounding) ou treinamento.
A controvérsia remonta ao início da ação judicial do New York Times, que exige compensação formal pelo uso sistemático de seu trabalho jornalístico.
O argumento de fair use
OpenAI e Microsoft sustentam que o treinamento de redes neurais se enquadra na doutrina de uso aceitável (fair use). As empresas defendem que o processo de aprendizado cria representações matemáticas transformadoras, sem reproduzir cópias diretas no produto final.
Contudo, na prática, o buraco é mais embaixo e há evidências recentes que contrariam esse argumento. A controvérsia de Navier-Stokes é um ótimo exemplo, que ajuda a alimentar a desconfiança no meio acadêmico.
Entretanto, essa interpretação recebeu respaldo institucional já que o governo dos Estados Unidos apresentou manifestação jurídica em defesa do uso aceitável para o avanço tecnológico, conforme analisado na cobertura sobre a posição do governo americano nesse caso.
A contradição econômica dos answer engines
A discussão transcende o âmbito estritamente legal. Na minha opinião, o modelo atual dos motores de resposta enfrenta um problema de incentivos econômicos. Afinal, a internet livre prosperou sob um pacto claro de indexação em troca de audiência qualificada. Porém, quando a plataforma retém a atenção do leitor e não transfere valor ao criador, corrói a base que viabilizou sua própria tecnologia, colocando em risco o seu próprio futuro. Pelo menos enquanto os resultados puramente sintéticos ainda são pouco relevantes.
O que isso significa para publishers
Os veículos de comunicação precisam reavaliar imediatamente suas estratégias de distribuição e distribuição técnica. As principais ações recomendadas incluem:
- Monitorar logs de servidores para identificar a atividade de robôs de inteligência artificial.
- Estabelecer regras transparentes em arquivos robots.txt para rastreadores de treinamento e busca.
- Diversificar receitas com canais proprietários, como newsletters, eventos e assinaturas pagas.
- Negociar acordos de licenciamento com desenvolvedores de modelos de linguagem.
A questão que os tribunais ainda precisam responder
O poder judiciário agora deve decidir se a transformação tecnológica justifica a substituição de mercado das fontes originais. A análise de impacto econômico será determinante para equilibrar inovação tecnológica e sustentabilidade da imprensa profissional. Por fim, qualquer definição definitiva sobre responsabilidade civil dependerá de revisão jurídica aprofundada dos tribunais e do julgamento do mérito das provas apresentadas.


Recentes
- Pesquisa Acadêmica