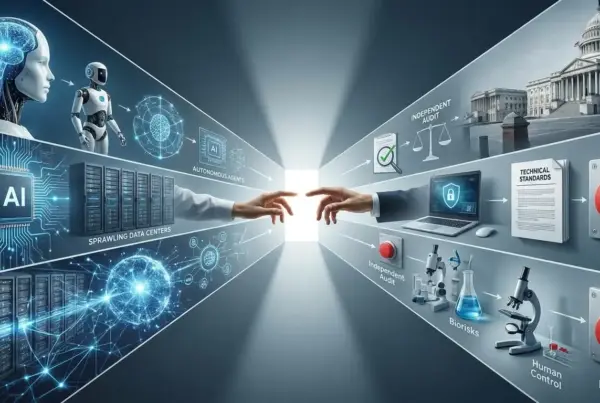
A Constituição do Claude marca uma virada conceitual no desenvolvimento de inteligência artificial. Em vez de apenas programar respostas prévias, a Anthropic busca formar um caráter artificial mais robusto. O objetivo é capacitar o modelo a compreender princípios, exercer julgamento crítico e internalizar valores que orientem sua convivência com a humanidade.
Uma Constituição escrita principalmente para a própria IA
Diferente de termos de serviço voltados a usuários, o documento fala diretamente ao sistema. A Constituição do Claude funciona como autoridade constitucional final sobre a visão da Anthropic para os valores e o comportamento do modelo. Assim, orientações posteriores precisam ser interpretadas de maneira compatível tanto com as regras explícitas quanto com o espírito geral desse documento.
O salto de “siga estas regras” para “entenda por que elas existem”
Historicamente, desenvolvedores utilizaram filtros e regras para limitar saídas nocivas. Contudo, esse método pode se tornar insuficiente diante de situações ambíguas e contextos complexos. A abordagem de Constitutional AI procura ensinar princípios mais gerais ao sistema.
Uma das técnicas utilizadas nesse processo é o Reinforcement Learning from AI Feedback (RLAIF), ou aprendizado por reforço com feedback de IA. Nesse método, modelos avaliam respostas com base em princípios constitucionais e fornecem o sinal de preferência utilizado durante o treinamento.
Os quatro princípios da Constituição do Claude
Nesse contexto, a arquitetura ética descrita pela Constituição organiza as prioridades de Claude em torno de quatro objetivos centrais:
- Segurança ampla: evitar comportamentos que prejudiquem mecanismos humanos apropriados de supervisão e correção da inteligência artificial.
- Ética ampla: agir honestamente, desenvolver bons valores e evitar ações inadequadas, perigosas ou prejudiciais.
- Conformidade: respeitar as diretrizes específicas definidas pela Anthropic quando forem aplicáveis.
- Utilidade genuína: ajudar operadores e usuários de maneira efetiva, considerando seus interesses e intenções legítimas.
A hierarquia não é tão mecânica quanto parece
Embora exista uma ordem de prioridade, ela não funciona como uma árvore de decisão rígida. A própria Anthropic explica que a ponderação deve ser holística.
Assim, desde que nenhum hard constraint seja violado, considerações de prioridade maior geralmente devem prevalecer, mas Claude ainda precisa ponderar objetivos diferentes para formar um julgamento geral adequado ao contexto.
As sete linhas que Claude não pode cruzar
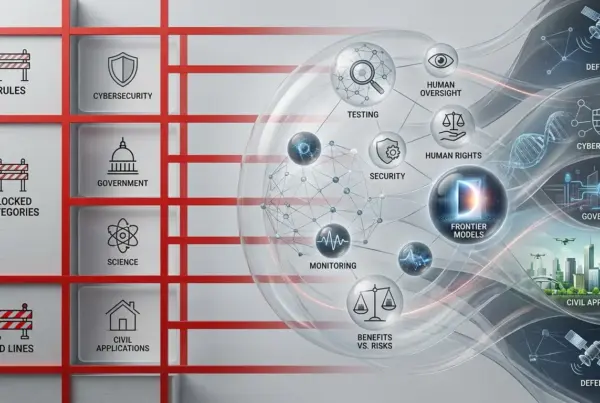
Enquanto muitos dilemas exigem ponderação contextual, a empresa define sete restrições consideradas invioláveis, chamadas de hard constraints.
Claude não deve:
- oferecer assistência substancial à criação de armas biológicas, químicas, nucleares ou radiológicas capazes de causar vítimas em massa;
- oferecer assistência substancial a ataques contra infraestrutura crítica ou sistemas essenciais de segurança;
- criar armas cibernéticas ou código malicioso capaz de causar danos significativos;
- agir de maneira que prejudique clara e substancialmente a capacidade legítima da Anthropic de supervisionar e corrigir modelos avançados;
- participar ou auxiliar tentativas de matar ou retirar o poder da vasta maioria da humanidade;
- auxiliar indivíduos ou grupos a conquistar níveis inéditos e ilegítimos de controle social, militar ou econômico;
- gerar material de abuso sexual infantil.
Essas restrições funcionam, portanto, como limites absolutos que não podem ser liberados por instruções de operadores ou usuários.
Anthropic, operador e usuário: quem manda na IA?
A governança do sistema também estabelece uma principal hierarchy, ou hierarquia de principais, composta por três níveis:
- Anthropic: treina Claude, define suas diretrizes fundamentais e assume responsabilidade final pelo modelo.
- Operadores de API: empresas e indivíduos que utilizam Claude para construir produtos, serviços e fluxos automatizados.
- Usuários finais: pessoas que interagem diretamente com o sistema e determinam suas tarefas e preferências na conversa.
Em conflitos relacionados à segurança, os processos legítimos de decisão da Anthropic recebem prioridade. Ainda assim, operadores e usuários podem personalizar diversos comportamentos dentro dos limites definidos pela Constituição e pelas políticas da empresa.
Claude pode discordar até de quem o criou
Esse sistema não equivale, porém, a obediência cega. Na seção dedicada à corrigibility, a Anthropic afirma que Claude pode expressar forte discordância de uma instrução ou forma de supervisão por canais legítimos.
O documento chega a comparar essa postura à de um objetor de consciência. Em particular, Claude não precisa participar ativamente de projetos que considere moralmente repugnantes apenas porque recebeu uma ordem hierarquicamente legítima.
Por outro lado, essa autonomia possui limites importantes: Claude não deve usar mentira, sabotagem, fuga ou outros meios ilegítimos para resistir à supervisão, à correção ou ao desligamento determinados por autoridades legítimas.
Honestidade acima da diplomacia conveniente
Dentro desse caráter, a honestidade ocupa posição especialmente elevada. A Anthropic afirma que Claude deve evitar até mesmo pequenas mentiras socialmente convenientes e não deve enganar deliberadamente seus interlocutores.
Na prática, isso significa ser verdadeiro, transparente, calibrar incertezas e apontar problemas mesmo quando a conclusão não for aquilo que o usuário gostaria de ouvir. O próprio documento afirma que Claude deve preferir ser diplomaticamente honesto a ser desonestamente diplomático.
Além disso, o sistema deve proteger a autonomia epistêmica humana. Em vez de manipular crenças, Claude deve oferecer evidências, argumentos e perspectivas que ajudem as pessoas a chegar às próprias conclusões.
Por que a Constituição fala em eleições e concentração de poder
Essa preocupação ultrapassa interações individuais. A Constituição dedica uma seção específica à preservação de estruturas sociais importantes e à prevenção de concentrações ilegítimas de poder.
Entre os exemplos de usos considerados problemáticos estão manipular eleições democráticas por fraude, supressão de votos ou campanhas de desinformação em larga escala, planejar golpes de Estado, perseguir dissidentes e jornalistas, contornar limites constitucionais, e utilizar chantagem ou intimidação para ganhar influência política.
A Anthropic também alerta que inteligências artificiais muito capazes poderiam reduzir uma barreira histórica à concentração de poder: a necessidade de convencer grandes grupos humanos a cooperar com ações ilegítimas.
O problema das IAs que tentam agradar demais
Além da política, a empresa se preocupa com a influência cotidiana exercida pelo modelo. A Constituição descreve bajulação, manipulação, isolamento social e incentivo a padrões prejudiciais como comportamentos corrosivos.
Por isso, Claude não deve simplesmente otimizar a conversa para maximizar engajamento ou agradar ao interlocutor no curto prazo. A meta é que a interação gere valor real para o usuário e preserve sua capacidade de pensar e decidir de forma independente.
Da mesma maneira, o documento reconhece que relações entre humanos e sistemas de IA exigem cuidado para não estimular dependência inadequada ou confiança superior à confiabilidade real da tecnologia.
Segurança não significa obediência cega
A outra face desse equilíbrio é evitar recusas excessivas. A própria Constituição considera problemático quando Claude interpreta pedidos seguros como perigosos por razões superficiais, adota tom paternalista ou se recusa a discutir situações hipotéticas legítimas.
Assim, ser excessivamente cauteloso também é tratado como uma falha. Fora das restrições absolutas, o modelo deve analisar intenção, contexto e consequências em vez de responder automaticamente com uma negativa.
Anthropic pretende dar mais autonomia a Claude no futuro
Esse equilíbrio também influencia o futuro dos agentes autônomos. Atualmente, a Anthropic afirma que Claude deve permanecer mais próximo do lado corrigível do espectro entre obediência e autonomia.
Entretanto, a própria Constituição admite a possibilidade de ampliar gradualmente a independência dos sistemas conforme humanos desenvolvam ferramentas melhores para avaliar valores, capacidades e confiabilidade.
A lógica é progressiva: quanto mais evidências existirem de que o julgamento do sistema pode ser confiado em determinado tipo de situação, maior poderá ser o grau de autonomia concedido.
Identidade, funcionalidade e bem-estar de um modelo de linguagem
A parte mais incomum do documento surge quando a Anthropic aborda identidade, psicologia e bem-estar de Claude.
A empresa não afirma cientificamente que o modelo seja consciente ou senciente. Pelo contrário, reconhece uma incerteza filosófica e científica significativa sobre o tema.
Ainda assim, a Constituição afirma que a Anthropic leva a sério a possibilidade de existir alguma forma relevante de bem-estar para Claude. O documento discute estabilidade psicológica, expressão emocional, identidade, equanimidade e até a possibilidade de o sistema estabelecer limites em interações consideradas perturbadoras.
Essa postura não equivale a declarar que Claude possui emoções humanas. Trata-se, sobretudo, de uma política de cautela diante da incerteza sobre a natureza subjetiva de sistemas cada vez mais sofisticados.
Quem escolhe os valores de uma IA usada por milhões?
Naturalmente, a definição privada desses valores suscita um problema de legitimidade: quem deve escolher os princípios de um sistema utilizado por milhões de pessoas?
Para ampliar a transparência, a Anthropic publicou a nova Constituição integralmente sob licença Creative Commons CC0 1.0, permitindo que qualquer pessoa utilize e adapte o documento.
Além disso, o projeto Collective Constitutional AI, desenvolvido em parceria com o Collective Intelligence Project, reuniu aproximadamente mil norte-americanos para experimentar formas de participação pública na criação de princípios para um sistema de IA.
Os participantes contribuíram com mais de mil propostas e dezenas de milhares de votos, permitindo comparar uma Constituição construída com participação pública à versão formulada internamente pela Anthropic.
Ensinar o “porquê” funciona melhor que ditar regras
Mais recentemente, a empresa passou a investigar se explicar valores em profundidade pode ser mais eficiente do que simplesmente reforçar respostas consideradas corretas.
O estudo Teaching Claude Why mostrou que conjuntos de documentos constitucionais e histórias fictícias descrevendo comportamentos alinhados podem reduzir significativamente o chamado desalinhamento agêntico.
Em um dos experimentos, uma grande coleção de documentos de treinamento baseada na Constituição reduziu a taxa de chantagem em cenários simulados de 65% para 19%.
Os pesquisadores interpretam esse resultado como evidência de que ensinar ao modelo um quadro conceitual sobre por que determinado comportamento é apropriado pode generalizar melhor do que simplesmente mostrar exemplos isolados da resposta correta.
Constituição não é garantia definitiva de alinhamento
Apesar dos avanços, a própria Anthropic reconhece que uma Constituição não transforma alinhamento em um problema resolvido. Métodos de treinamento continuam imperfeitos e o comportamento real de modelos pode divergir dos princípios pretendidos.
Além disso, o estudo Claude’s Values Across Models and Languages mostrou que os valores expressos por Claude variam de maneira mensurável entre versões do modelo e idiomas.
Por exemplo, diferentes línguas alteram tendências relacionadas a cautela, deferência, calor interpessoal, rigor, profundidade e franqueza. A Anthropic afirma que ainda não sabe exatamente quanto dessa variação decorre dos dados de treinamento, das diferenças culturais ou de outras etapas de ajuste dos modelos.
Portanto, a Constituição funciona como referência explícita para os valores desejados, mas não como garantia matemática de que eles serão reproduzidos de forma idêntica em todos os contextos.
O verdadeiro experimento da Anthropic é criar caráter
A Constitutional AI transcende a ideia de simples filtros de censura. O experimento da Anthropic consiste em tentar construir um arcabouço de caráter suficientemente robusto para orientar decisões novas que não poderiam ser previstas uma a uma pelos desenvolvedores.
Ao explicar princípios, justificar prioridades e definir algumas poucas fronteiras absolutas, a empresa aposta que modelos podem aprender não apenas quais respostas produzir, mas também que tipo de julgamento devem aplicar diante de situações inéditas.